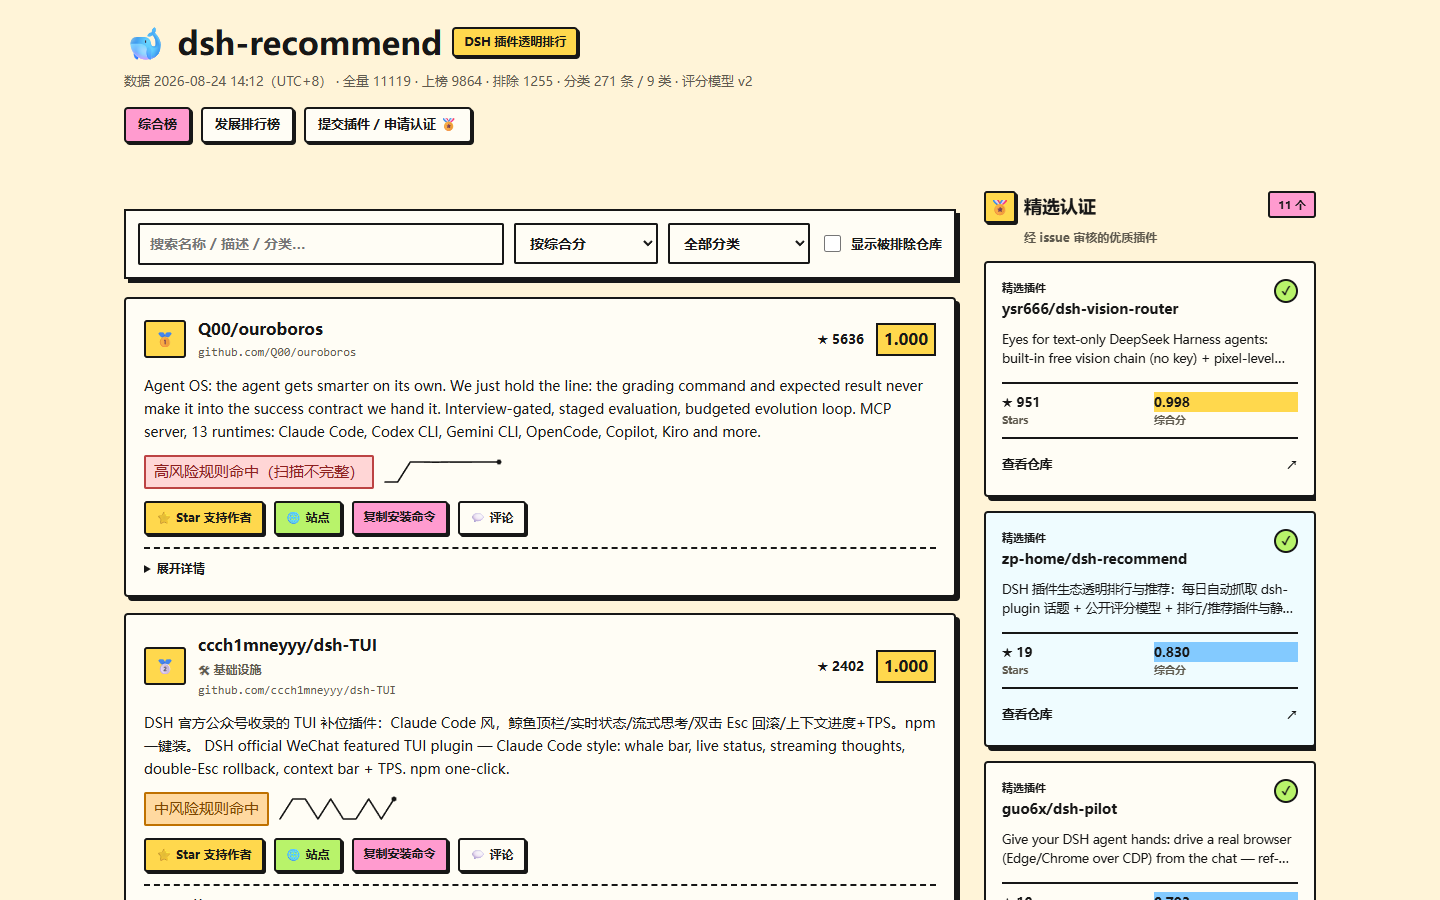
DSH Recommend 最初是一个插件目录,但真正消耗工程时间的不是做榜单页面,而是回答两个问题:如何让评分可以复查,以及如何让安全扫描既不漏掉危险组合,也不把正常插件全部判成高危。
数据为什么选择静态生成
- 设计每日自动采集和静态数据生成流程。
- 建立公开评分模型和推荐维度。
- 将结果输出为无需后端服务的静态站点。
- 为异常仓库、缺失字段和重复插件保留可追踪的处理路径。
采集结果、评分权重、排除原因和生成时间跟随仓库版本管理。GitHub Actions 周期性重算后,站点、DSH 插件工具和外部消费者读取同一份 registry。这样可以回溯“一次排名为什么变化”,也避免为了目录站维护常驻数据库;代价是数据存在更新延迟,GitHub API 限额和上游字段缺失必须被显式记录。
问题一:第一版扫描器把 12 个插件全部判成 high
加入执行、网络、密钥与 CI 规则后,扫描结果一度看起来“覆盖很广”:12 个被扫描插件全部是 high,MKT-EXEC-001 单条规则触发 952 次。这个结果实际上没有可用性,因为正常 Electron 应用中的每个 exec() 都被重复记分。
我在 PR #26 中逐条回查证据,定位出五类系统性错误:同一文件/规则重复生成 finding、shutdown 误匹配方法名、.env 误命中 process.env、shell 内建 exec 被当作 Node 能力,以及 composite 与 workflow 检查重复计数。修复后,正常 Electron 样本从数百条 high 降为 2 条 medium;真正的 exec(variable) 加破坏性命令、密钥外传和危险 CI 仍保持 high。
问题二:同一文件出现两个词,不代表它们构成攻击链
第二轮扫描仍有 11/18 个插件为 high。根因变成了“文件级相关性”:文件开头有 exec('npm build'),远处文档或清理代码出现 rm -rf,扫描器就把两者拼成破坏性执行;Buffer.from() 与远处的 eval() 也会被错误组合。
PR #28 把这些判断收窄到调用点附近 150 字符窗口,并区分 scripts/ 中应检查的 curl | bash 与不应泛化的假密钥。这个数字不是安全理论上的完美距离,而是一个可测试的工程约束:先阻断远距离拼接,再通过真实样本和 smoke cases 调整规则。
问题三:降低误报不能等于降低检测能力
在后续 PR #32 中,我又补入跨语言执行/外传关联、SSRF、压缩包目录穿越、请求到 sink 注入、Trojan Source、可变 Actions ref 和 reusable workflow secrets 等规则,同时把“能力线索”与“强证据高风险”分开。75 个规则 ID 都必须有 impact 映射;finding 保留代码片段、攻击向量、CWE、证据置信度与风险调整理由。
这也形成了项目的核心取舍:扫描器可以提示审查位置,但不能替代人工代码审计、依赖漏洞分析、动态沙箱或官方安全背书。榜单中的低风险不是“安全认证”。
问题四:DSH 升级后整个 Host 进入 Recovery
在 DSH 0.1.2-alpha.1 中,上游删除了已被吸收的 dsh-client-runtime。项目仍从其 /client 子路径导入 ClientContext,于是新 Desktop 直接无法启动。当前 PR #36 按新运行时改为 Cordis Context,显式补回 slots 与 plugin inventory 的类型增强,并在真实 vendored runtime 下完成 typecheck 与构建。
排查还暴露了另一个容易忽略的问题:link: 安装会把整个开发目录连同本地 node_modules/@deepseek-ai 挂进 Profile,旧依赖会遮蔽宿主新版包;package.json.files 只约束发布包,并不能保护本地链接。这个 PR 仍为 open,网站不会把它写成已经发布的兼容结果。
我从这个项目学到的
规则数量、finding 数量和“全部高危”都不是质量指标。一个可用的审计结果必须能回答:具体哪段代码、在什么上下文、为什么构成风险、哪些证据只够提示而不够定罪,以及修正规则后哪些真阳性仍然保留。